„Context Engineering“ ist eines der Schlagworte, unter denen über KI-Agenten gesprochen wird. Unsere These: Das Wort ist neu, die Arbeit dahinter ist es nicht. Wer verstehen will, was der Begriff verspricht und was davon trägt, kommt schnell bei einer Disziplin an, die Datenteams seit Jahren kennen.
Das Versprechen hinter dem Begriff
„Context Engineering“ trägt ein stilles Versprechen: dass Agenten daran scheitern, was man ihnen zeigt, und dass eine Disziplin des Auswählens das behebt. Das Versprechen ist halb richtig, und die richtige Hälfte ist alt. Ein Agent antwortet aus dem, was er sehen kann. Kann er nicht sehen, welche Definition von Umsatz die geprüfte ist, welcher Kundendatensatz der echte ist oder welche Fassung einer Richtlinie gilt, dann rät er, und ein stärkeres Modell rät flüssiger.
Ein viel wiederholtes Beispiel kommt von Atlan: Ein Agent sagte der Finanzabteilung, der Umsatz im vierten Quartal habe 12 Millionen US-Dollar betragen, während die echte Zahl bei 8,4 Millionen lag, weil er revenue_recognized las, wo er revenue_net_of_returns hätte lesen müssen. Das Modell hat sich nicht verrechnet. Niemand hatte ihm gesagt, welche Spalte die vereinbarte Bedeutung trägt. Atlan verkauft Werkzeuge für Datenkataloge, nehmen Sie die Geschichte also als Veranschaulichung eines Mechanismus und nicht als Messung, wie oft er auftritt.
Die Umfragen zeigen auf die Daten
Die Umfragen der Jahre 2025 und 2026 sagen immer dasselbe Unglamouröse. Das Capgemini Research Institute fand, dass das Vertrauen in vollständig autonome KI-Agenten in einem Jahr von 43 % auf 27 % fiel, wobei 80 % der Organisationen keine ausgereifte KI-Infrastruktur haben, um sie zu tragen (Capgemini, 2025). Eine Studie von Cloudera und Harvard Business Review Analytic Services aus März 2026 fand, dass nur 7 % der Unternehmen sagen, ihre Daten seien vollständig bereit für KI.
Beides sind Umfrageergebnisse, und die Befragten definieren „bereit“ und „Vertrauen“ selbst. Sie passen zum Mechanismus oben und beweisen ihn nicht. Die bescheidene Lesart lautet: Der Engpass, den die meisten benennen, sind die Daten und nicht die Qualität der Modelle.
Ein neues Etikett für eine alte Disziplin
Sehen Sie sich an, was die Behebung des Atlan-Problems verlangt: eine geprüfte Definition pro Kennzahl, eine kanonische Kennung pro Kunde, eine Aufzeichnung, woher jede Zahl kam, und Regeln darüber, wer was sehen darf. Datenteams haben dafür längst Namen: Kennzahldefinitionen, Stammdatenverwaltung, Lineage, Zugriffssteuerung. Context Engineering ist weitgehend diese Disziplin, neu beschriftet für einen neuen Abnehmer. Wer solide Stammdaten hat, brauchte das neue Wort nie, und wer sie nicht hat, konnte das Problem damit nicht beheben. Ein Begriff, der keiner der beiden Gruppen dient, hat nach unserer Einschätzung eine kurze Haltbarkeit, so wie vor ihm „prompt engineering“.
Was daraus folgt
Das Vokabular wird vergehen, die Arbeit nicht. Drei Dinge folgen daraus, und keines davon braucht den Begriff.
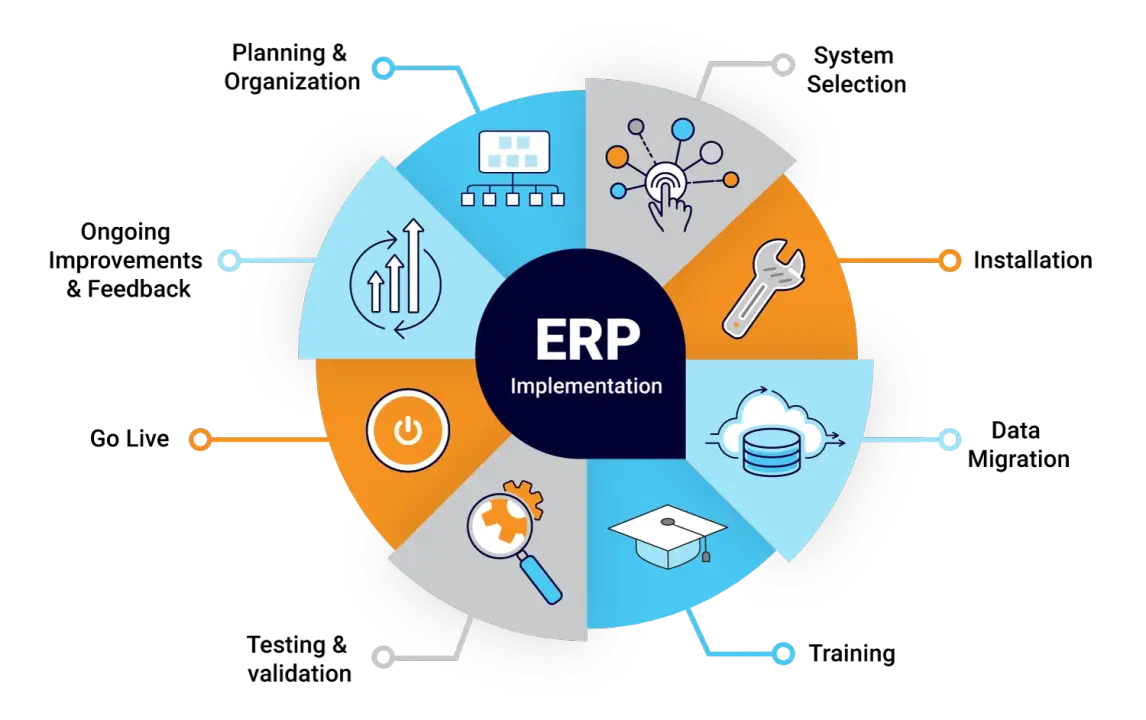
Erstens hat ein Unternehmen, das Odoo oder ERPNext betreibt, einen Teil dieser Arbeit schon getan, ob es jemand so geplant hat oder nicht. Der Kontenplan ist ein geprüfter Satz von Definitionen. Der Artikelstamm und die Partnertabelle sind kanonische Kennungen. Statusfelder in Dokumenten sagen, welche Fassung gilt, und rollenbasierter Zugriff begrenzt bereits, wer was sieht. ThinqHub implementiert beide Systeme, wir wissen also, wie viel „Kontext“ in einem gut geführten ERP schon liegt. Ein Agent, der das ERP über eine enge, berechtigte Schnittstelle abfragt, erbt diese Definitionen; ein Agent, der auf einen Data-Lake-Export derselben Tabellen zeigt, erbt die Spaltennamen und sonst nichts. Das Umgekehrte gilt auch: Hat das ERP doppelte Kunden, Freitextfelder dort, wo Codes stehen sollten, und drei Leute, die „abgeschlossen“ verschieden benutzen, wird kein Agent das reparieren. Er wird es selbstsicher zitieren.
Zweitens gehört manches Verhalten außerhalb des Modells. Ein Agent in einer Bank muss die Identität prüfen, bevor er über einen Saldo spricht, und ein schlussfolgerndes Modell kann diese Reihenfolge nicht in jedem Lauf garantieren. Salesforce macht denselben Punkt in seinem Beitrag zu Agententrends 2026. Setzen Sie solche Regeln in gewöhnlichen Workflow-Code, wo sie getestet sind und sich nicht von einer geschickten Eingabe wegdiskutieren lassen. Eine Regel, die nur in einem Prompt lebt, ist genau das, worauf Prompt Injection zielt.
Drittens ist Kontext nicht die Verbindungsebene. Protokolle wie MCP, behandelt in unserem Beitrag zur Interoperabilität von KI-Agenten, lassen einen Agenten ein System erreichen. Der Kontext entscheidet, was er dort versteht.
Ein Anfang, der zu einem kleinen Unternehmen passt: Nehmen Sie die zwei oder drei Zahlen, über die Ihr Team streitet, etwa realisierter gegen gebuchten Umsatz oder aktiver Kunde gegen registriertes Konto. Schreiben Sie die eine Definition auf und wer sie verantwortet. Richten Sie jeden Agenten und jede ERP-Schnittstelle auf diese Definition aus und lassen Sie sie zu jeder Zahl die Quelle mitliefern. Entscheiden Sie, was jeder Agent lesen darf, statt Zugriff auf den ganzen Bestand zu gewähren.
Das ist die Vorarbeit vor einem Einsatz agentischer KI, und die Reihenfolge zählt: zuerst die Daten, danach die Modellwahl. Unser Vorgehen beginnt damit zu prüfen, ob Ihre Daten einen Agenten überhaupt tragen können. Melden Sie sich bei uns, um Ihre Lücken zu finden, bevor Sie darauf bauen.