Eine Zeit lang lief der Streit darüber, ob Entwickler KI-Coding-Agenten überhaupt nutzen würden. Er endete, ohne dass ihn jemand für beendet erklärte. An seine Stelle trat ein anderer Streit, der um Vertrauen, und die Zeitleiste der letzten rund achtzehn Monate zeigt am klarsten, wie aus dem einen das andere wurde.
Vor etwa zwei Jahren: skeptisch, und ohne Zuständigkeit. Eine Zusammenstellung von Ergebnissen aus Stack Overflow, JetBrains und DORA durch Digital Applied setzt das Vertrauen der Entwickler in KI-generierten Code zu Beginn dieses Zeitraums bei 40 % an. In einem gesonderten Unternehmensdatensatz desselben Herausgebers benannten 11 % der Unternehmen eine zuständige Person für Agenten. Halten Sie beide Zahlen zusammen: Die meisten Entwickler trauten dem Ergebnis nicht, und die meisten Unternehmen hatten niemanden benannt, der dafür einstand.
Ein Jahr vor der Umfrage 2026: Copilot liegt vorn. GitHub Copilot lag bei 29 % Verbreitung unter professionellen Entwicklern. Es war die Vorgabe, weil es das eine Werkzeug war, von dem alle gehört hatten.
Januar 2026: das Feld sortiert sich neu. Claude Code lag bei 18 %. In den folgenden Monaten hat sich der Wert mehr als verdoppelt.
Mai bis Juli 2026: die Gewohnheit ist allgemein. Der JetBrains Developer Ecosystem Survey 2026, erhoben mit mehr als 15.000 Entwicklern, fand neun von zehn, die bei der Arbeit mindestens wöchentlich einen KI-Coding-Agenten einsetzen, und 68 %, die täglich einen einsetzen. Die Anteile nach Werkzeug hatten sich vollständig neu geordnet. Sie summieren sich auf mehr als 100 %, weil Entwickler mehrere nutzen.
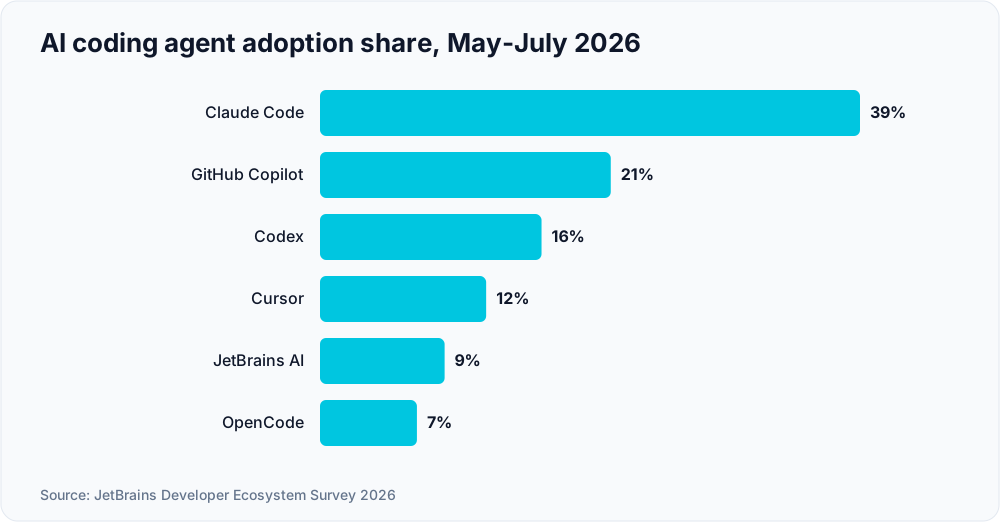
| Werkzeug | Verbreitungsanteil |
|---|---|
| Claude Code | 39 % |
| GitHub Copilot | 21 % |
| Codex | 16 % |
| Cursor | 12 % |
| JetBrains AI | 9 % |
| OpenCode | 7 % |
Quelle: JetBrains Developer Ecosystem Survey 2026. Claude Code ging im Halbjahr von 18 % auf 39 %. Copilot fiel von 29 % auf 21 %. Codex hat sich etwa verfünffacht.
Dieselben Monate: schneller fertig, weniger Zutrauen. In kontrollierten Studien berichten Entwickler, Aufgaben 55 bis 56 % schneller abzuschließen, so die Zusammenstellung von Digital Applied. In derselben Zusammenstellung trauen nur 29 % dem KI-generierten Code zu, korrekt zu sein, nach 40 % zwei Jahre zuvor, und Pull Requests mit KI-Mitautorschaft tragen mehr gemeldete Mängel als rein menschliche. Die Zuständigkeit für Agenten im Unternehmen ging den anderen Weg, von 11 % auf 56 % in zwei Jahren. Den Unternehmen fiel auf, dass jemand entscheiden muss, was der Agent anfassen darf und wer seine Arbeit prüft.
Eine Zahl, die wir zurückziehen. Eine frühere Fassung dieses Artikels subtrahierte zwei Statistiken voneinander und erzeugte daraus eine „Produktionslücke“ von 49 Punkten: den Befund von Gartner, dass 80 % der Unternehmensanwendungen, die Anfang 2026 ausgeliefert oder aktualisiert wurden, mindestens einen KI-Agenten eingebettet haben, und den Befund von S&P Global Market Intelligence, dass 31 % der Unternehmen einen Agenten produktiv betreiben. Diese Subtraktion nehmen wir zurück. Die beiden Zahlen kommen von verschiedenen Häusern mit verschiedenen Definitionen, die eine zählt Anwendungen, die andere Unternehmen, und „bettet einen Agenten ein“ ist nicht das Gegenteil von „betreibt einen Agenten produktiv“. Jede Zahl ist für sich in Ordnung. Zusammen messen sie nichts.
Was die Entwicklungslinie bedeutet
Lesen Sie die Zeitleiste als eine Linie. Code zu erzeugen wurde billiger, das Zutrauen fiel, das meistgenutzte Werkzeug wechselte innerhalb eines Jahres, und die Zuständigkeit kam zuletzt nach. Code zu schreiben war nie der langsame Teil, wenn man Software liefert, auf die es ankommt. Ihn zu prüfen, zu testen und dafür einzustehen war es, und die Agenten haben den günstigen Teil noch günstiger gemacht. Ein Team, das mehr erzeugten Code feiert, ohne seine Prüfkapazität mitwachsen zu lassen, hat sich eine Warteschlange gebaut.
Der Werkzeugwechsel trägt seine eigene Lehre. Wenn sich die Spitze innerhalb eines Jahres ändern kann, übersteht ein Plan das nicht, der den Agenten eines Anbieters als festen Bestandteil behandelt. Bauen Sie den Prüfprozess, die Zugriffsgrenzen und die Testschranken um die Arbeit herum, und behandeln Sie den Agenten als austauschbares Teil.
Wenn Sie Software in Auftrag geben, stehen Ihre Lieferanten längst in dieser Zeitleiste. Für ein Unternehmen, das Odoo oder ERPNext betreibt, ist ein großer Teil der Individualarbeit Code: Module, Berichte, Schnittstellen. Fragen Sie jeden Einführungspartner, uns eingeschlossen, wer von Agenten geschriebenen Code prüft und wie („ein Entwickler sieht sich das an“ ist eine Antwort, „der Agent prüft sich selbst“ nicht), wo Agenten aufhören (Geld, Compliance und Kundendaten verdienen eine zeilenweise Prüfung durch Menschen), was auf einer Staging-Umgebung getestet wird, bevor es Ihr Produktivsystem erreicht, und welche Zugriffe das Werkzeug selbst hält. Ein Agent mit Produktionszugangsdaten ist ein Einfallstor, wie unser Beitrag zu Prompt Injection erklärt. Was Pilotprojekte ins Stocken bringt, behandelt unser Beitrag zu Fehlern bei der Einführung agentischer KI.
ThinqHub implementiert Odoo und ERPNext, und unser Vorgehen stellt die Disziplin der Umsetzung vor das Werkzeug, das in diesem Quartal in Mode ist. Wenn Sie Individualarbeit zuschneiden und das Prüf- und Testmodell vereinbart haben wollen, bevor die erste Zeile geschrieben ist, sprechen Sie mit uns.